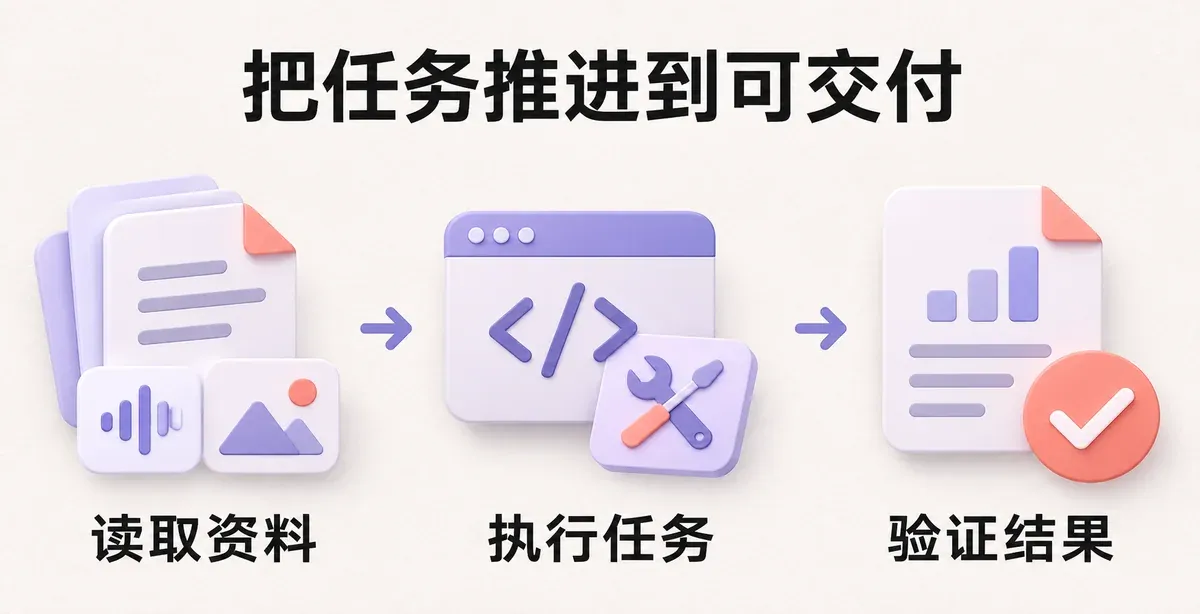
修复一个 bug,往往要经历读代码、查资料、修改、运行测试和再次验证。整理一份报告,也可能要在 PDF、表格、图表和录音之间来回切换。AI 在这些工作里是否好用,很大程度上取决于它能否连续、准确地把每一步推进下去。
2026 年 11 月 12 日,Google 发布 Gemini 4 Hydrogen,将它定位为面向日常编程和智能体工作流的快速执行模型。它既可以独立处理任务,也可以与 Gemini 4 Carbon、Argon 协作,承担代码修改、工具调用和验证等工作。[1]
这次发布值得关注的,是更强的执行能力、更细的思考级别控制,以及覆盖整个 100 万 token 上下文窗口的统一价格。对于开发者、内容创作者和经常处理复杂资料的人,这些变化都能落到具体的使用场景上。
Hydrogen 在 Gemini 4 家族里负责什么
按照 Google 的官方分工,Carbon 擅长高难度、长流程的深度推理,例如系统架构、复杂调试和科学问题;Argon 面向多数高级长流程任务,强调相对 Carbon 更少的 token 用量;Hydrogen 则侧重日常工作的执行效率。[1][3]
以软件开发为例,可以让 Carbon 推敲系统接口或分析棘手问题,再由 Hydrogen 完成明确范围内的修改、测试和结果检查。Hydrogen 本身也支持独立完成编程与资料分析任务,不要求先搭建多模型系统。
Google 同时在 Antigravity 中推出 Orchestrator,让同一会话可以动态切换模型。官方称,在 Terminal-Bench 4.0 上,这种编排方式取得了接近 Carbon 的任务成功率,平均配额消耗减少 24%,完成时间缩短 19%。这些数字描述的是编排方案在该项测试中的表现,不能直接算作 Hydrogen 单模型的速度或价格优惠。[1]
从写代码,到整理复杂资料
更快地推进代码修改
Google 强调 Hydrogen 对代码仓库的检索、问题定位、局部修改和测试验证能力。它可以将相互独立的文件读取与搜索工具调用成批并行执行,并在工具失败或搜索无结果时调整做法。[1][3]
官方发布文章称,相对 Gemini 3.8 Flash,Hydrogen 在默认 high 思考级别下完成任务的速度达到 2.5 倍,Terminal-Bench 4.1 得分从 18.2% 提升到 57%,编造性陈述也显著减少。这是 Google 发布的测试结论;实际项目中的收益还会受任务复杂度、工具响应、重试次数和思考设置影响。[1]
对于维护已有项目的人,值得实际检验的是:它能否读懂现有约束、把修改控制在需要的范围内,并用测试说明改动有效。一次生成多少行代码,并不能充分反映这些能力。
把多种材料整理成可用结果
Hydrogen 支持文本、图片、视频、音频和 PDF 输入,API 模型页列出的输出类型为文本;它还支持函数调用、代码执行、结构化输出、文件搜索和 Google Search 检索等能力。[2]
这些能力适合把多份材料放进同一项任务,例如结合会议录音与需求文档整理行动清单,比较长篇 PDF 中的图表与文字结论,或者从多份业务材料中提取字段并生成结构化报告。
实际使用时,需要给它明确的交付要求:每个结论标明来源;材料缺失时列出空缺;估算、原文事实和建议分别写清楚。输入支持多种媒体,并不表示该模型能够直接生成图片或音频——当前 API 模型页未列出这两类生成能力。[2]
让网页原型更快进入可操作阶段
Google 展示了交互式 3D 地球、电商页面和电子表格动画等案例,突出从自然语言需求到可运行原型的能力。[1]
对产品和设计工作而言,可以先用它做一个带真实交互的页面,检查信息是否清楚、操作是否顺手,再继续完善视觉和业务逻辑。官方演示说明了可能的应用方向;自己的项目仍需要检查移动端布局、数据连接和关键操作是否有效。
100 万 token 窗口,要看清共享预算
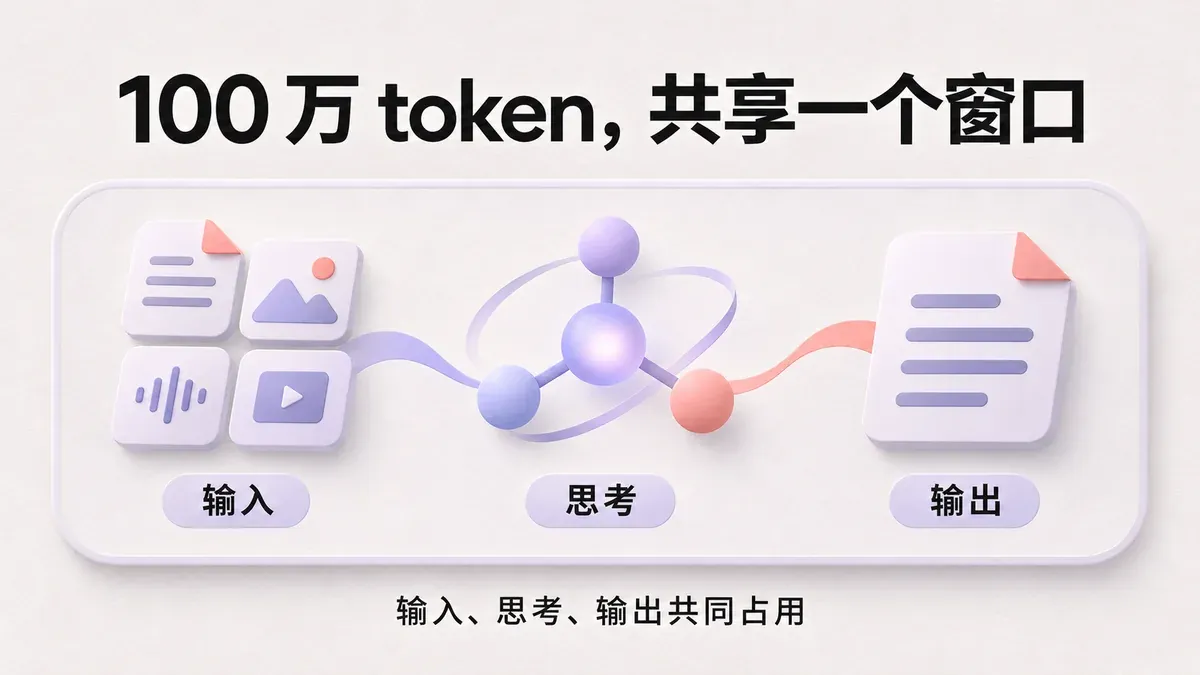
Hydrogen 的统一上下文窗口为 1,048,576 token。输入、思考和输出共用这一个窗口。[2][3]
因此,放入大量材料后,留给推理和生成结果的空间会相应减少。规划长报告、整库代码分析或超长对话时,要同时计算材料体积与预期结果长度。
输出限制也有两层:
| 使用方式 | 官方文档列出的限制 |
|---|---|
| 默认同步请求 | 最高 65,536 token |
| Long decode 长输出 | 通过后台执行或客户端续接,延伸至统一窗口允许的范围,最高约 100 万 token |
超过 64K 的长输出需要相应的后台执行或续接机制;仅打开后台执行而不提高输出上限,仍会在默认上限处停止。思考也会占用输出预算,接入时需要给最终答案留下空间。[3]
四档思考级别,按任务选择
Hydrogen 提供 low、medium、high 和新增的 xhigh 四档思考级别,默认使用 high。[3]
| 思考级别 | 更适合的任务 |
|---|---|
low |
重视成本和响应速度的日常对话、大批量处理 |
medium |
交互式编程、页面原型、需要快速反馈的工具调用 |
high |
多数复杂编程、智能体执行和多模态资料处理,官方推荐的默认起点 |
xhigh |
high 难以解决的多步骤难题,可以接受更多等待与 token 消耗时 |
Google 报告,Hydrogen 在 Artificial Analysis Intelligence Index 上,默认 high 得分为 51,xhigh 为 54;发布文章给出的 Argon 对照分数为 50。[1] 这一综合指标提供了一个观察角度,具体任务还需要看对应评测。
例如,官方模型卡列出以下结果:[5]
| 评测 | Hydrogen 得分 | 主要观察方向 |
|---|---|---|
| Terminal-Bench 4.1 | 57.0% | 终端环境中的任务执行,官方标注为作弊调整后结果 |
| Agents’ Last Exam v1.1 | 71.6% | 专业工作流任务 |
| MKA | 53.4% | 复杂视觉资料上的多模态知识工作,指标为 Climb WSR accuracy |
| OSWorld-2.1 | 77.6% | 计算机操作,结果对应离线子集 |
同一份官方表中,Claude Sonnet 5.5 在 Terminal-Bench 4.1 和 OSWorld-2.1 上分别为 63.9% 与 83.9%,均高于 Hydrogen。选择模型时,应结合自己的任务类型、运行时间和成本判断;这些成绩也有各自的测试环境,不能直接当作任意真实任务的成功率。
API 多少钱,哪些费用容易漏算
截至 2026 年 11 月 13 日,Google 官方价格页列出的 Hydrogen 费用如下,单位均为美元/100 万 token:[4]
| 计费项目 | Standard 标准请求 | Batch 批处理 |
|---|---|---|
| 输入 | $1.50 | $0.75 |
| 输出,包含思考 token | $7.50 | $3.75 |
| 缓存命中的输入 | $0.075 | $0.0375 |
标准输入、输出单价覆盖整个 100 万 token 窗口。缓存只支持隐式缓存,不支持显式缓存;缓存价仅适用于命中的输入,不能套用到全部输入。[3][4]
举个便于估算的例子:一次标准请求处理 10 万个未缓存输入 token,产生 1 万个输出 token(含思考),基础推理费用约为 0.225 美元。这里未计入搜索等额外工具费用,也未计入后续重试。
思考 token 按输出计费,所以最终答案较短,也可能产生较多推理用量。使用 Google Search 等检索工具时,还要核对工具费用及其免费额度。评估成本时,最好记录一项任务从开始到验证通过的总消耗。[3][4]
现在可以从哪里使用
Google 宣布 Hydrogen 自 11 月 12 日起在开发者、企业和消费者产品中全球逐步推出。[1]
| 入口 | 使用时需要了解的条件 |
|---|---|
| Google AI Studio、Gemini API | 提供免费与付费层级;免费使用有速率限制,API 模型 ID 为 gemini-4-hydrogen |
| Gemini App | 官方注明,免费用户通过自动模型选择,在适合的提示词上获得 Hydrogen,并非保证每次对话都使用它 |
| Google Antigravity | 官方本次发布说明面向付费 Google AI Pro、Ultra 订阅用户开放 |
| Gemini for business、Google Sheets | 按产品与订阅资格开放;Sheets 的消费者入口从 Google AI Pro、Ultra 用户开始 |
| Google Search | 作为搜索体验升级逐步推出 |
想先体验,可以打开 Google AI Studio 的 Hydrogen 页面,选择一项自己熟悉、结果容易检查的工作。产品正在逐步推出,具体入口和额度以账号当前显示为准。
已有 Gemini 3.8 Flash 应用的开发者,还需要阅读迁移说明:Hydrogen 默认思考级别改为 high,不支持 minimal;显式缓存需要移除;temperature、top_p、top_k 的自定义值会被忽略;工具调用需要按原生接口声明,并正确保留多轮会话状态。[3]
模型卡同时列出,Hydrogen 的知识截止时间为 2026 年 3 月,并可能出现幻觉、超时或较高 token 消耗。[5] 查询最新产品、政策和价格时,仍应让它检索资料并给出可核对的来源。
Hydrogen 值得尝试的地方,是把代码、材料和工具串成一段推进更快的工作流程。可以用一个反复出现的真实任务来检验它:完成需要多久、结果要改几次、验证是否通过、总共花了多少。对于日常使用,这些记录会比一次漂亮演示更有参考价值。
资料核查日期:2026 年 11 月 13 日。本文依据下列官方发布文章与文档整理,评测数字为来源方公布结果,未进行独立性能实测。配图为 AI 生成的编辑插画与流程示意。