在过去两年大模型风起云涌的浪潮中,实时语音交互(Voice Agent)始终处于一种微妙的“夹生”状态。
早期以“ASR(语音识别)+ 文本 LLM + TTS(语音合成)”为代表的串联级联架构,不仅带来了难以忍受的 1~3 秒端到端延迟,更在生硬的文本转译中彻底磨灭了人类对话的情绪温度与韵律顿挫。随后,原生音频模型(如初代 GPT-4o 语音模式、早期 Gemini Live)虽实现了低延迟全双工,却很快撞上了另一堵坚硬的高墙——“能聊的没脑子,有脑子的会卡死”:
“如果你要求模型像真人一样秒回,它往往只能给出未经深思熟虑的浮浅寒暄;而一旦你要求它检索工单数据库、排查代码报错或推演复杂逻辑,整个语音流便会瞬间陷入长达 5~10 秒的‘死寂时刻’(Dead Silence)。在真实的电话或实时交互中,用户常常误以为通话已掉线或服务器崩溃。”
2026年9月15日,继前不久推出惊艳业界的 Gemini 3.8 Flash 与专攻网络安全的 Flash Cyber 之后,谷歌正式向全球推送了语音智能领域的重磅核弹:Gemini 3.8 Live 以及搭载深度思考机制的 Gemini 3.8 Live Extended Thinking。
新模型不仅以 82.6 分 的绝对优势强势登顶权威机构 Artificial Analysis 全球端到端语音评测榜首,更首次带来了颠覆性的“异步推理协议(Asynchronous Reasoning Protocol)”,彻底攻克了实时语音 Agent 在高智商运算下的停顿死锁。
一、 双旗舰矩阵:极速交互 vs 深度长程慢思考
面对企业级与消费级场景对“响应速度”与“逻辑智商”的不同权重,谷歌本次采用了清晰的双模型分层策略:
1. Gemini 3.8 Live(主力低延迟交互层)
- 设计核心:追求极限的吞吐量、极低推理成本与亚秒级首包音频响应。
- 全双工体验:原生 Speech-to-Speech 架构,直接完成音频 Token 的端到端流式互译,彻底摒弃传统 ASR+TTS 中间态。
- 视觉接地(Visual Grounding):支持在通话过程中无缝接入实时摄像头或屏幕分享流,实现所见即所聊。
- 适用场景:高并发客服接待、移动端实时翻译与语音陪伴、智能车载交互。
2. Gemini 3.8 Live Extended Thinking(高阶长程深度推理层)
- 设计核心:将前沿的“Thinking Mode(深度思考模式)”与强化学习推理首次注入原生流式语音信道。
- 海量上下文:支持 131,072 输入 Tokens 与 65,536 输出 Tokens 的超大上下文容量,保障长程复杂对话状态不漂移。
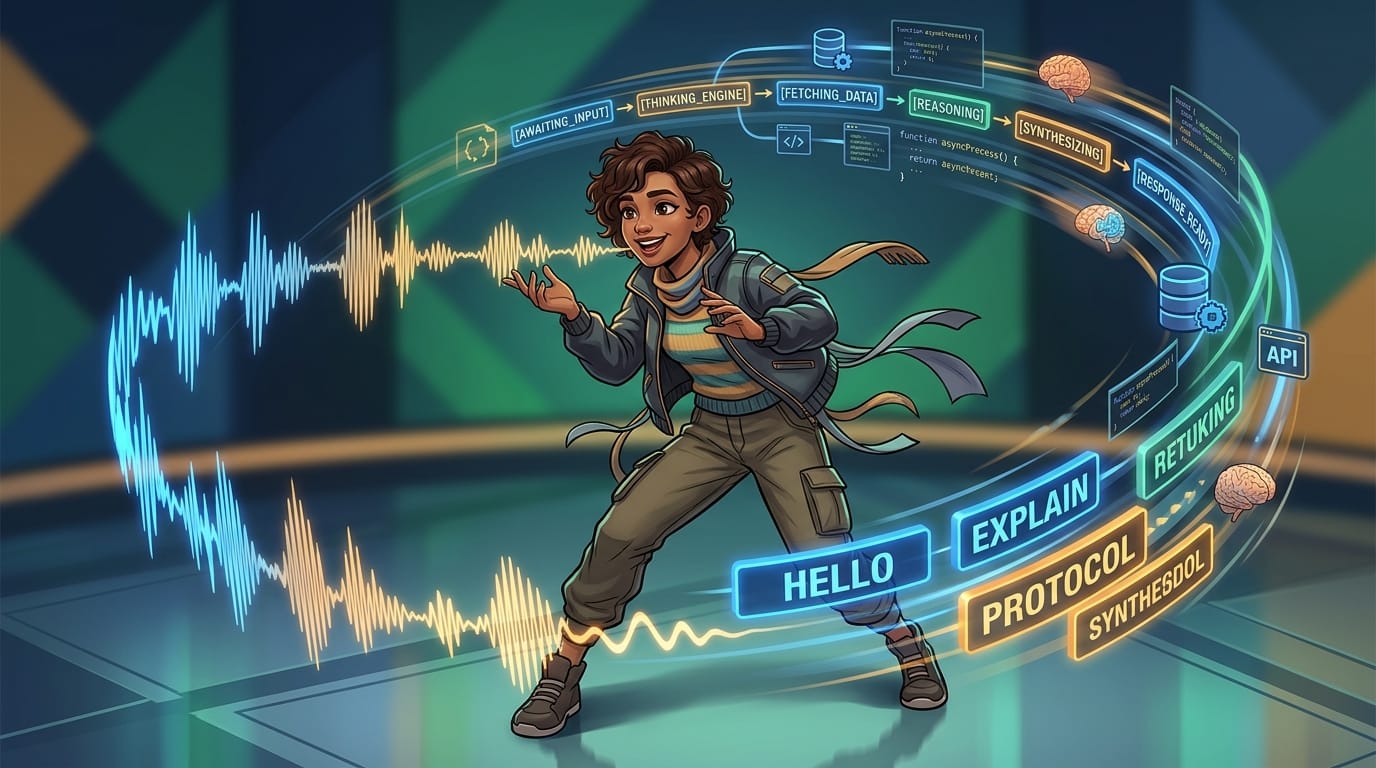
- 核心杀手锏:首创“异步推理协议”,允许模型在后台并行展开多步规划、交叉验证与外部 API 编排,同时在前台持续保持自然发声与状态同步。
- 适用场景:金融风控审计排查、IT 架构复杂故障语音现场排障、多系统并发调度的企业级 Agent。
二、 核心技术破局:“异步推理协议”如何终结“死机式停顿”?
长久以来,实时语音系统的状态机是严格单线程阻塞的:[用户输入] ➔ [模型闭嘴并运算] ➔ [模型组织语言并回复]。这正是“死寂时刻”的物理根源。
而在 Gemini 3.8 Live Extended Thinking 中,谷歌研发团队打破了这一桎梏,构建了双轨交错推理架构(Interleaved Reasoning Architecture):
1. 主会话保活轨(Continuous Dialogue Track)
当用户提出一个高度复杂的分析任务(例如:“帮我对比过去三个月华东区和华北区服务器集群的负载峰值,并排查上周五的报警归因”)时,模型并不会陷入沉默,而是通过高度自然的话语垫片(Verbal Fillers)与思维外显旁白(Out-loud Narration)与用户持续沟通:
“好的,这个分析需要交叉比对监控日志与报警时序。我正在调取华东集群的监控快照,请稍等一两秒……”
“华东区的指标已经拉取完毕,整体水位正常,我现在切入华北区日志,正在比对上周五 14:00 的网络 I/O 尖峰……”
2. 后台深度推理轨(Background Reasoning Track)
在模型保持自然说话的同时,其内部的推理计算核心在静默执行长程 Chain-of-Thought(思维链)推理,并以完全异步非阻塞的方式(Asynchronous Function Calling)并发触发多个后端微服务与数据库 API。外部系统的响应数据在毫秒级被回灌至推理注意力窗口中。
3. 平滑合流与认知无缝衔接
一旦后台多步验证得出确定性结论,主会话轨立即以自然的转折词(如“找到了核心症结所在……”)将深度分析成果平滑融入对话输出中。在用户的听觉感知中,模型就像一位坐在身旁的资深架构师——一边有条不紊地跟你交流进展,一边双手在键盘上飞速检索排查,毫无机械僵死感。
三、 原生端到端声学魔力:97 种语言与毫秒级打断
除了推理逻辑的质变,Gemini 3.8 Live 在声学物理层面的表现同样拉满了技术张力:
- 真实声学情绪共鸣:得益于端到端语音建模,模型能够直接从音频频谱中感知用户的语气急促、疲惫、犹豫或兴奋,并在回复中自适应调整自己的呼吸节奏、重音停顿与语速,甚至在轻松话题下展现自然的笑意与幽默感。
- 超灵敏双向打断(Barge-in):在全双工通信管道中,以往语音助手常常在被打断时出现“刹不住车”继续胡言乱语的情况。Gemini 3.8 Live 将打断响应时间压缩至百毫秒内,用户随时插话,模型能立即优雅收声并针对最新上下文重构回复。
- 97 种语言毫秒级同句混杂(Dynamic Code-Switching):模型支持多达 97 种语言的原生识别与生成。即使开发者在对话中高频混杂中英文专有名词(如“帮我 review 一下这段 microservice 的 async worker 逻辑,看看有没有 memory leak”),模型也能精准无误地进行跨语言混合理解与发声。
- 全模态视觉接地(Visual Grounding):不仅能听,还能实时“看”。在打开视频流模式下,Gemini 3.8 Live 能以原生多模态帧率处理动态画面,用户指着主板上的电容问“这个元件烧了吗”,模型能结合视线焦点直接语音引导。
四、 硬核战报:登顶全球权威榜单与 Agentic 实测
在权威独立 AI 测评机构 Artificial Analysis 最新公布的基准测试中,Gemini 3.8 Live 系列展现了统治级的技术领先:
| 评估维度 / 基准测试 | 传统级联架构 (ASR+LLM+TTS) | 第一代端到端语音模型 | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|---|---|
| Artificial Analysis 语音质量指数 | 68.2 | 76.4 | 80.8 | 82.6(全球总榜 No.1) |
| τ-Voice 语音智能体任务完成率 | 38.5% | 51.2% | 61.4% | 68.6%(大幅领跑) |
| Sierra τ-Voice-banking(银行业务长程测试) | 18.3% | 24.7% | 29.5% | 35.1%(高压容错顶尖) |
| Big Bench Audio(复杂声学推理) | 72.1% | 85.6% | 93.2% | 97.7% |
| 端到端声学延迟 | 1200ms ~ 2500ms | 600ms ~ 900ms | 300ms ~ 500ms | 流式保活 + 异步推理 |
| 复杂工具调用处理方式 | 阻塞停顿 3~8 秒 | 无法处理或易丢上下文 | 后台静默调用 | 边聊边调用 + 思维外显 |
在极度严苛的 τ-Voice-banking 评测中,模型需要通过纯语音交互,在多轮对话中处理跨账户转账、异地挂失、双重身份验证与复杂条款解读。Gemini 3.8 Live Extended Thinking 凭借其扎实的逻辑推理与异步容错机制,将行业上限从 20%+ 一举拉升至 35.1%,证明了其在金融级场景下的实用价值。
五、 企业安全与生态落地:从玩具到生产环境
长久以来,许多前沿语音模型因为安全性与深度伪造顾虑而迟迟无法大规模商用。谷歌在 Gemini 3.8 Live 的工程落地中部署了严密的安全与生态闭环:
1. 全链路内嵌 SynthID 声学水印
模型生成的所有音频流均在频域底层嵌入了不可感知的数字水印 Google SynthID。即使音频经过压缩编码、格式转换或环境重采样,检测端依然能够可靠鉴别其 AI 生成源头,为企业级防范声纹伪造与电话诈骗提供了底层合规护盾。
2. 全栈生态全向覆盖
- 个人终端:深度整合进 Gemini Live 原生应用与 Google Search Live 搜索场景;
- 协作套件:全面赋能 Google Workspace(Gmail 实时邮件口述摘要、Docs 文档语音共创、Keep 语音任务编排);
- 企业私有化:通过 Gemini Enterprise for Customer Experience 开放私有化定制接入;
- 开发者基础设施:官方在 Google AI Studio 与 Gemini API 开放实时连接接口(Live API),并宣布已与 LiveKit、Pipecat、LangChain 与 Vercel 达成深度生态合作,提供一键部署生产级语音 Agent 的工程模板。
六、 实战前瞻:基于 Live API 的异步语音 Agent 接入姿势
对于一线开发者而言,接入 Gemini 3.8 Live 极为简洁。借助双向 WebSockets 或 WebRTC,开发者可以像连接流媒体一样推送音视频分片,并注册异步工具函数:
// 伪代码示例:基于 WebSockets 连接 Gemini 3.8 Live 异步推理引擎
const liveSession = new GeminiLiveClient({
  model: 'gemini-3.8-live-extended-thinking',
  apiKey: process.env.GEMINI_API_KEY,
  config: {
    generationConfig: {
      responseModalities: ['AUDIO'],
      speechConfig: {
        voiceConfig: { prebuiltVoiceConfig: { voiceName: 'Puck' } }
      }
    },
    systemInstruction: {
      parts: [{ text: '你是一名资深云原生运维专家,支持边思考边向用户同步进度。' }]
    },
    tools: [
      { functionDeclarations: [queryClusterMetrics, restartDeployment] }
    ]
  }
});

// 处理全双工流式收发
liveSession.on('audioDelta', (pcmChunk) => {
  audioSpeaker.play(pcmChunk); // 实时播放模型发声
});

liveSession.on('toolCallAsync', async (toolCall) => {
  console.log('检测到后台异步工具触发:', toolCall.name);
  const result = await executeTool(toolCall.name, toolCall.args);
  liveSession.sendToolResponse(toolCall.id, result); // 后台平滑灌入推理结果
});
七、 总结:语音交互的“奇点时刻”已经到来
从 2011 年 Siri 诞生至今,人类与机器的语音对话整整徘徊了十五年。在这十五年里,语音助手大多数时候只被当作查天气、设闹钟的“智障遥控器”。
而 Gemini 3.8 Live 的发布,真正让语音从“边缘辅助工具”蜕变为“智能体的一等公民(First-class Citizen)”。通过将原生端到端声学建模与异步深度推理协议融为一体,谷歌向整个行业证明了:语音 Agent 不仅可以比真人更敏捷,更可以比专家更深邃。
当大模型既能听懂你叹息中的焦虑,又能一边温和安慰你、一边在后台飞速排查完复杂集群的千万行日志时,人机协作的下一个十年,才算真正拉开了大幕。